ADK Agent
L'ADK Agent è un Service ALIDA a esecuzione continua basato su Google ADK. Espone le API native di ADK e un wrapper compatibile con OpenAI e può essere specializzato tramite prompt, skill e servizi collegati.
Specializzazione tramite dataset
All'avvio, l'ADK Agent scopre le skill in un dataset MinIO di ALIDA. Una struttura tipica è:
skills/
  domain-workflow/
    SKILL.md
    references/
guide.mdViene scaricata solo la sottocartella skills/. I file SKILL.md definiscono procedure che l'agente può usare quando servono; gli altri contenuti del dataset non vengono caricati. Lo stesso runtime può quindi essere specializzato per domini diversi cambiando il dataset e riavviando l'agente.
Memory ADK Agent
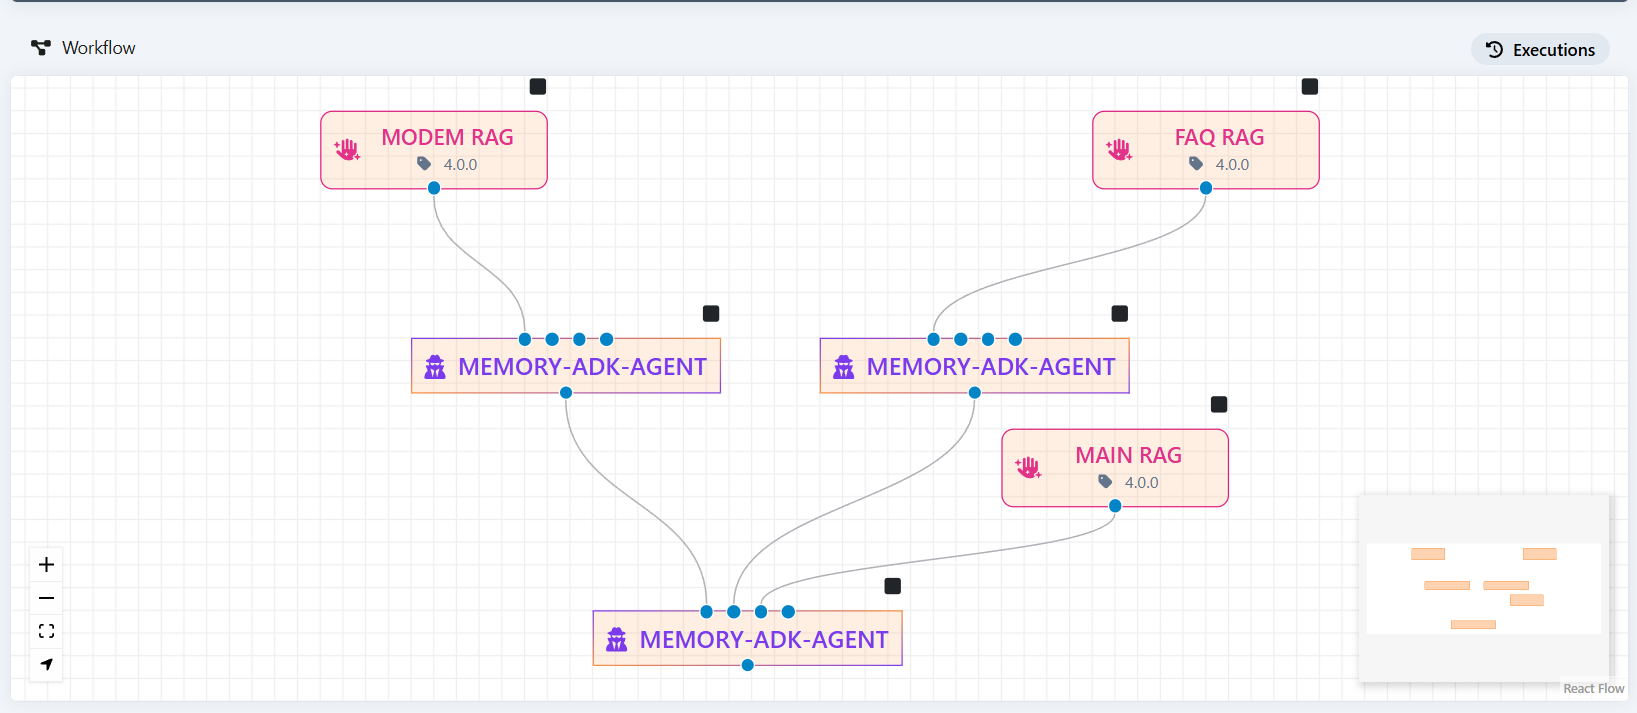
Il Memory ADK Agent è un esempio di questo runtime. Mantiene lo stato della conversazione e i dati dell'utente, si collega a servizi ALIDA esposti come server MCP (ad esempio BraveSearch o GitLab) e può delegare ad agenti ADK remoti tramite agent card A2A. Espone inoltre un server MCP utilizzabile da agenti come l'agente OpenCode.
Specializzazione del dataset del Memory Agent
Collega un dataset MinIO alla porta input-dataset dell'agente nel workflow. Ogni skill ha una propria cartella e un file SKILL.md che descrive quando applicarla. Per esempio, skills/domain-workflow/SKILL.md può contenere:
---
name: domain-workflow
description: Applica i passaggi specifici del dominio a un'attività.
---

Segui i passaggi descritti in references/guide.md per questa attività.All'avvio, l'agente scarica la sottocartella skills/ del dataset, inclusi i riferimenti all'interno di ogni skill, in SKILLS_DIR e registra le skill valide con ADK. La cartella predefinita è src/agents/memory_agent/skills/: per lo sviluppo locale puoi inserirvi direttamente le skill oppure impostare un altro percorso con SKILLS_DIR. Se il dataset non è raggiungibile, l'agente registra l'errore nel log e si avvia senza quelle skill.
L'agente può avere più porte di ingresso per dataset, che lo collegano a funzionalità diverse:
| Input | Utilizzo |
|---|---|
Dataset MinIO contenente skills/ | Scarica le skill all'avvio. |
| Dataset di tipo endpoint che punta a un server MCP | Rende disponibili gli strumenti del server all'agente. |
Dataset di tipo endpoint il cui URL termina con /.well-known/agent-card.json | Rileva un agente A2A remoto e lo registra come sotto-agente. |
Gli URL dei dataset di tipo endpoint che terminano con /.well-known/agent-card.json sono trattati come agent card A2A; gli altri URL di tipo endpoint come server MCP. Per lo sviluppo locale, i server MCP possono essere configurati anche con MCP_SERVERS.
Strumenti dell'agente e ciclo operativo
Il Memory ADK Agent può usare:
get_usernameeupdate_usernameper recuperare o modificare il nome dell'utente salvato;- le skill caricate dal dataset, gli strumenti dei server MCP collegati e i sotto-agenti A2A remoti.
All'avvio registra le skill e le connessioni disponibili. Durante una conversazione sceglie le funzionalità in base alle istruzioni configurate e alla richiesta dell'utente; lo stato della sessione è salvato dal servizio di sessione ADK configurato. L'agente può essere invocato tramite le API native di ADK o il wrapper compatibile con OpenAI.
Configurazione
Il form del servizio espone i seguenti campi:
| Campo | Obbligatorio | Descrizione |
|---|---|---|
MODEL | Sì | Nome del modello servito da BASE_URL. |
TEMPERATURE | Sì | Temperatura di campionamento. |
MAX_TOKENS | No | Numero massimo di token per risposta. |
BASE_URL | Sì | Endpoint compatibile con OpenAI; il valore predefinito è l'MLflow AI Gateway. |
API_KEY | Sì | Chiave per BASE_URL. |
AGENT_INSTRUCTION | Sì | JSON con prompt, name e description. name deve essere un identificatore Python valido: è il nome dell'applicazione ADK, il model dell'API compatibile con OpenAI e il percorso /a2a/<name> dell'agent card. |
DATABASE_URL | Sì | Database usato dal servizio di sessione ADK. |
Il tracciamento verso MLflow non richiede configurazione: la piattaforma fornisce MLFLOW_TRACKING_URI e le trace vengono registrate nell'esperimento con il nome di FATHER_ID (in mancanza, BDA_ID), salvo che sia impostato MLFLOW_EXPERIMENT_NAME. Si può aggiungere un collector OpenTelemetry generico con OTEL_EXPORTER_OTLP_ENDPOINT; TELEMETRY_BACKEND (auto, none, mlflow, otlp) sceglie quali backend attivare.
Invocare l'agente
Le API native di ADK consentono di invocare direttamente l'agente e di gestirne sessioni e stato. Copia l'URL base dell'agente in esecuzione dal Workflow Designer in AGENT_URL (senza /v1) e sostituisci memory_agent con il name impostato in AGENT_INSTRUCTION. Crea la sessione prima della prima richiesta a /run:
curl -X POST "$AGENT_URL/apps/memory_agent/users/alice/sessions/session-001"Poi invia un messaggio:
curl -X POST "$AGENT_URL/run" \
	-H "Content-Type: application/json" \
	-d '{
		"appName": "memory_agent",
		"userId": "alice",
		"sessionId": "session-001",
		"newMessage": {
			"role": "user",
			"parts": [{"text": "Come mi chiamo?"}]
		}
}'Il wrapper OpenAI permette invece di usare client e interfacce già compatibili con questo standard, come Open WebUI e LangChain. Per ottenere i modelli disponibili:
curl "$AGENT_URL/v1/models"Per inviare un messaggio tramite l'endpoint OpenAI-compatible /v1/chat/completions:
curl -X POST "$AGENT_URL/v1/chat/completions" \
	-H "Content-Type: application/json" \
	-d '{
		"model": "memory_agent",
		"messages": [
			{"role": "user", "content": "Come mi chiamo?"}
		],
		"user": "alice",
		"session_id": "session-001"
}'I campi aggiuntivi user e session_id non fanno parte dello standard OpenAI: il wrapper li usa per associare la richiesta a un utente e mantenerne la memoria conversazionale. Il wrapper crea la sessione se necessario, quindi qui non serve la chiamata di creazione della sessione nativa mostrata sopra. Mantieni gli stessi valori nelle richieste successive per continuare la conversazione.
Per ricevere la risposta in modo incrementale, aggiungi "stream": true alla richiesta compatibile con OpenAI. L'endpoint restituisce Server-Sent Events (SSE) con i delta di testo; se il modello fornisce contenuti di ragionamento, i delta della chat in streaming li includono in reasoning (e in reasoning_content per i client meno recenti):
curl -N -X POST "$AGENT_URL/v1/chat/completions" \
	-H "Content-Type: application/json" \
	-d '{
		"model": "memory_agent",
		"messages": [{"role": "user", "content": "Come mi chiamo?"}],
		"user": "alice",
		"session_id": "session-001",
		"stream": true
}'Per collegare l'agente alla chat ALIDA, usa lo streamingUrl della piattaforma descritto in Configurare un agente nella chat; è diverso dall'URL /v1/chat/completions usato per le richieste SSE dirette.
Interfaccia di sviluppo dell'agente
La UI di sviluppo dell'agente è disponibile all'URL della BDA con il suffisso /dev-ui/:
https://<url-istanza-alida>/events/bda/<bda-id>/<service-id>/dev-ui/Ad esempio:
https://alida.devng.alidalab.it/events/bda/8344/8370/dev-ui/Slash finale obbligatorio
L'URL della UI deve terminare con /. L'indirizzo senza slash finale potrebbe non caricare correttamente le risorse dell'interfaccia.
Dopo il deploy e l'avvio dell'agente, collegarne l'endpoint compatibile con le API OpenAI alla chat della BDA seguendo Configurare un agente nella chat. Per il tracciamento e la governance delle richieste, vedere Osservabilità con MLflow.