OpenCode Agent
OpenCode è l'agente operativo di ALIDA. Espone le sue API e streaming SSE e può essere specializzato per un dominio attraverso un dataset di discovery.
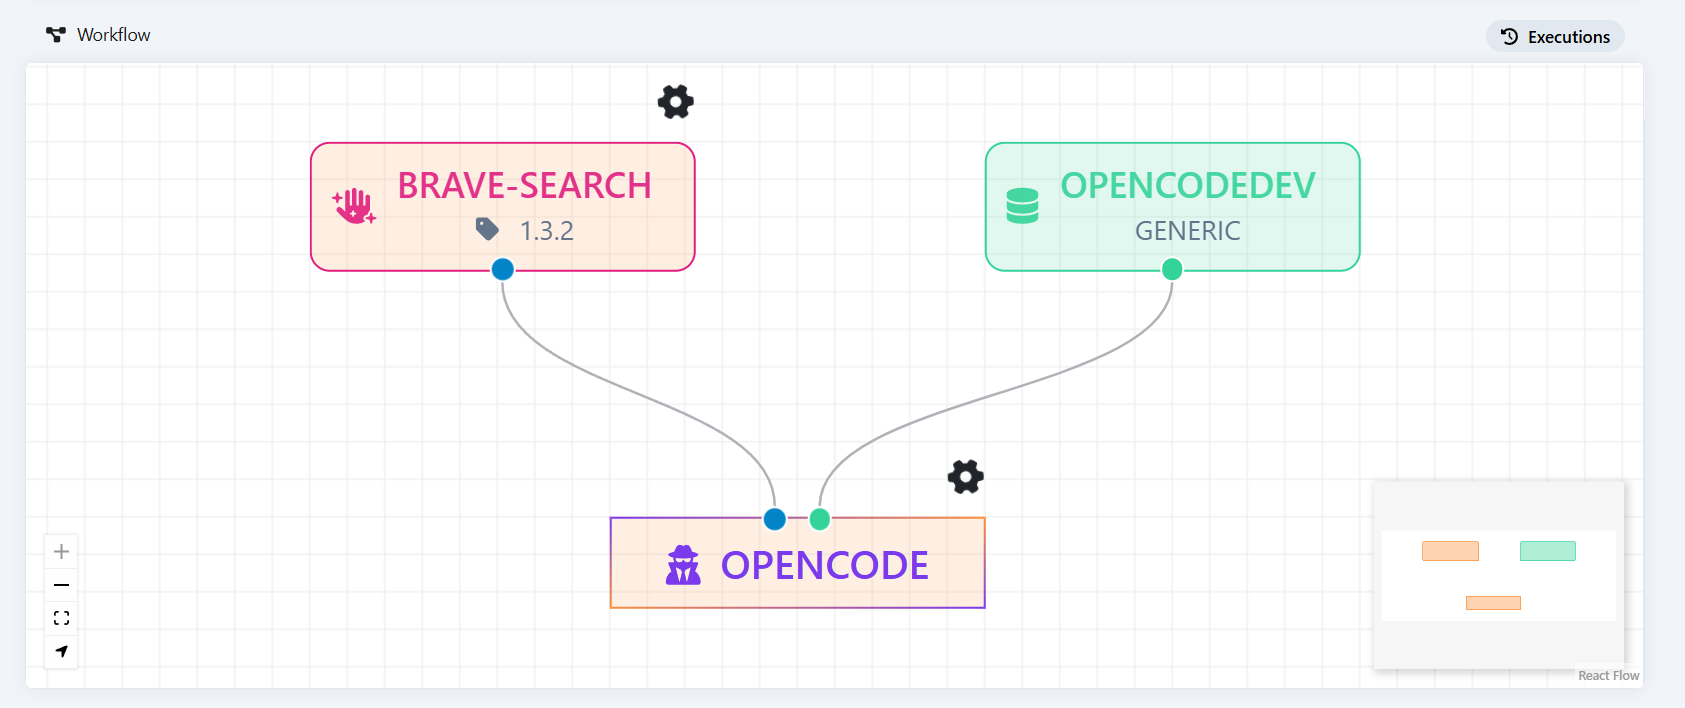
Input: dataset e server MCP
TIP
OpenCode può essere collegato sia a dataset, che specializzano l'agente con istruzioni, skill e tool, sia a server MCP remoti, che forniscono capability aggiuntive. Entrambi si configurano come porte di ingresso di tipo dataset e l'agente accetta più porte.
Dataset
Durante l'avvio, OpenCode scarica il dataset e ne unisce i file in /opencode, mantenendo i relativi percorsi. Per specializzare il runtime, fornire un dataset per il dominio di destinazione.
La porta si passa come --input-dataset (oppure --input-dataset-N per le porte aggiuntive) con il prefisso S3, insieme ai suffissi .s3_bucket, .s3_URL, .s3_ACCESS_KEY, .s3_SECRET_KEY e ai suffissi facoltativi .s3_REGION (predefinito garage) e .use_ssl. L'avvio fallisce se un prefisso non contiene file.
Una struttura tipica del dataset è:
AGENTS.md
opencode.json
agents/
  domain-expert.md
skills/
  domain-workflow/
    SKILL.md
tools/
  domain-tool.ts
plugins/
  domain-plugin.ts
init.d/
  ...
reference-documentation.mdLa struttura è interamente facoltativa: non è necessario creare o riempire tutte le cartelle. Includere solo i file necessari; poiché ogni file viene scritto in /opencode nel proprio percorso, un file con lo stesso percorso viene sovrascritto.
I contenuti del dataset hanno ruoli distinti:
AGENTS.mdcontiene le istruzioni condivise e globali che guidano l'agente principale e i sottoagenti.opencode.jsonè la configurazione di OpenCode: modello e provider, server MCP locali, permessi e file di istruzioni. All'avvio viene estesa con il plugin MLflow e con i server MCP remoti collegati come porte di ingresso. Per maggiori dettagli, vedere Config | OpenCode.agents/contiene file Markdown, uno per sottoagente specializzato. Ogni file ne definisce il ruolo, le competenze e le istruzioni operative, ad esempio per un esperto del dominio. Per ulteriori esempi su come definire un sottoagente, fare riferimento a Agenti | OpenCode.skills/contiene procedure riutilizzabili. Ogni skill ha una propria cartella e un fileSKILL.mdche descrive quando applicarla e quali passaggi eseguire. Per maggiori dettagli, vedere Competenze dell'agente | OpenCode.tools/contiene strumenti personalizzati che l'agente può invocare durante una conversazione. Gli strumenti sono definiti in file JavaScript o TypeScript e possono eseguire integrazioni o script del dominio. Per maggiori dettagli, vedere Strumenti personalizzati | OpenCode.plugins/contiene plugin JavaScript o TypeScript che estendono OpenCode tramite hook sugli eventi, ad esempio per integrare servizi esterni, modificare il comportamento dell'agente o aggiungere strumenti. Per maggiori dettagli, vedere Plugin | OpenCode.init.d/contiene lo scaffold copiato nella repository di lavoro all'avvio; i file già presenti nella repository non vengono sovrascritti. Per un esempio, vedere lo scaffold del Service Writer.- I file di documentazione di riferimento del dominio restano fuori da
agents/e vengono richiamati dalle istruzioni o dai prompt quando necessario.
Prompt, skill, tool, agenti ausiliari e documentazione presenti nel dataset determinano la specializzazione effettiva dell'agente. Lo stesso runtime può quindi essere riutilizzato in domini diversi cambiando il dataset.
Server MCP
Una porta diventa un server MCP remoto quando --input-dataset-N.metadata contiene metadati JSON in cui datasetFileType.type vale endpoint e datasetFileType.details.url è l'indirizzo del server:
--input-dataset-2.metadata='{"name":"my-mcp","datasetFileType":{"type":"endpoint","details":{"url":"http://host:8000"}}}'Il nome del server è il campo name convertito in slug; l'URL viene normalizzato in modo che termini con /mcp e ne viene verificata la raggiungibilità prima di aggiungerlo alla configurazione di OpenCode. Una porta con .metadata non viene mai scaricata da S3.
OpenCode può usare capability fornite da un server MCP, incluso un ADK Agent. Non può invece essere usato come server MCP da ADK.
Esempio: Service Writer di ALIDA
Nel caso del Service Writer, OpenCode lavora su una repository associata alla BDA e usa un dataset orientato ad ALIDA. Il flusso comprende in genere:
- definizione o aggiornamento di
.alida/spec.md; - lettura della documentazione rilevante;
- implementazione del codice del Service;
- generazione e validazione di
src/arguments.pyemeta-model.json; - produzione della documentazione e della configurazione CI;
- test, commit, push e apertura della merge request dopo il successo della pipeline.
All'avvio, OpenCode crea o clona una repository nel namespace della BDA e, se MLflow è configurato, crea o recupera il corrispondente esperimento MLflow. Il BDAID mantiene il legame tra la chat, gli artefatti e il contesto operativo.
Comportamento all'avvio in dettaglio:
- OpenCode viene eseguito in
/workspace; la repository del servizio viene clonata in/workspace/service, quindi ogni percorso del servizio scritto dall'agente inizia conservice/. - Se
GIT_URLè impostata, la repository viene clonata e gli eventuali file obbligatori mancanti vengono copiati al suo interno. Non viene creato alcun progetto GitLab. - Se
GIT_URLè vuota, viene creato (o riutilizzato) un progetto GitLab con il nome diBDA_IDconvertito in slug, nel gruppo identificato daGITLAB_GROUP, con branch predefinitoGIT_BRANCHoppuredevelop. Il progetto viene quindi clonato e, se appena creato, inizializzato con lo scaffold iniziale del servizio. - L'autenticazione Git usa esclusivamente
GITLAB_TOKEN, tramite HTTP o HTTPS. - Se
MLFLOW_TRACKING_URInon è impostata, l'esperimento MLflow viene saltato e l'agente viene eseguito senza il plugin@mlflow/opencode.
Scaffold del servizio
I file obbligatori provengono da /opencode/init.d (modificabile con INIT_DIR). Ogni file viene copiato nella repository solo se non esiste già, quindi i file esistenti non vengono mai sovrascritti. Poiché i dataset di ingresso vengono uniti in /opencode prima della preparazione della repository, un dataset può fornire un proprio init.d/ per sostituire lo scaffold.
.alida/
  spec.md
  iterations.md
src/
  main.py
  arguments.py
  utils.py
tests/
  .gitlab-ci-test.yml
  seed.py
  run_scenarios.py
.gitlab-ci.yml
Dockerfile
docker-compose.yml
documentation.md
meta-model.json
requirements.txtLo scaffold è un segnaposto e così com'è non è né valido né eseguibile: meta-model.json ha name e url vuoti, src/main.py non contiene logica, docker-compose.yml ha un command vuoto e i file di test contengono marcatori FILL. Un name vuoto indica al sottoagente metamodel-writer che il servizio è nuovo (versione 1.0.0). L'agente riscrive questi file durante il ciclo operativo e validate-metamodel ha esito positivo solo dopo questa fase.
Dataset ALIDA
Il dataset determina cosa conosce l'agente di coding e come si comporta. Per il Service Writer, il dataset ALIDA fornisce prompt, skill e il file alida-documentation.md specifici per ALIDA.
Strumenti dell'agente e ciclo operativo
L'agente principale è istruito per sviluppare servizi ALIDA dispone dei seguenti tool:
validate-metamodel: convalidameta-model.jsone il relativo filesrc/arguments.pyrispetto al contratto dei servizi ALIDA.generate-gitlab-ci: genera la configurazione CI standard di ALIDA, inclusa la fase di registrazione del servizio.commit-and-push-service: l'unico modo con cui l'agente consegna un servizio. Inseriscedocumentation.mdinmeta-model.json:markDown.value(da cui la piattaforma ricava il manuale visualizzato nell'interfaccia utente), imposta la versione, convalida il meta-modello e rifiuta il commit se non è valido, antepone la voce di changelog in.alida/iterations.md, quindi esegue commit e push sufeat/<service-name>dopo aver verificato che la repository corrisponda aGIT_URL. Non esiste un tool separato per l'inserimento della documentazione.get_useful_info: restituisce informazioni deterministiche sull'ambiente di esecuzione, tra cui la data corrente, l'utente che sta operando e ilproject_idGitLab.take-a-coffee: attende da 10 a 300 secondi (predefinito 30) tra due controlli della pipeline, così l'agente non esaurisce il budget di polling mentre un job è ancora in esecuzione.- gitlab-mcp: server MCP che consente all'agente di interagire con GitLab. Sono abilitati solo questi tool:
list_pipelines,get_pipeline,list_pipeline_jobs,get_pipeline_job_output,list_merge_requests,create_merge_request,get_merge_request_conflicts,search_repositories,create_repository.
Il dataset ALIDA fornisce anche queste skill:
write-service-tests: scrive i test end-to-end della CI, con un seed e una matrice di scenari (un'esecuzione di base più una per parametro, oltre ai casi limite).brainstorming: trasforma una richiesta vaga in una specifica scritta e condivisa prima dell'inizio dello sviluppo.caveman: modalità di risposta compressa (lite,full,ultra) che riduce i token in uscita e resta attiva per la sessione finché non viene disattivata.
Permessi GitLab
Per eseguire commit, push e creare branch, l'identità GitLab configurata deve disporre dell'accesso al gruppo in cui viene scritta la repository, con almeno il ruolo Maintainer: il ruolo Developer non è sufficiente per creare branch.
Il ciclo operativo inizia con la creazione o la revisione di .alida/spec.md, quindi legge la documentazione ALIDA relativa alle integrazioni richieste. L'agente implementa il servizio, delega al sottoagente metamodel-writer la generazione di src/arguments.py e meta-model.json, convalida il risultato e delega al sottoagente documentation-writer la documentazione destinata agli utenti. Genera quindi la configurazione CI e scrive i test end-to-end. Infine commit-and-push-service inserisce la documentazione nel meta-modello, registra l'iterazione e pubblica il branch feat/<service-name>; l'agente attende la pipeline, interrogandola con take-a-coffee fino a 20 volte, e, se necessario, corregge gli errori della pipeline. Dopo una validazione completata con successo, apre una merge request. Il merge in develop o dev avvia la build e la registrazione del servizio usando il meta-model.json fornito.
Documentazione di riferimento e validazione
L'agente legge la documentazione ALIDA da una copia locale in sola lettura in /opencode/docs, a partire da /opencode/docs/index.md. La copia descrive la struttura del servizio (core.md), il meta-modello (meta-model.md), Spark (spark.md) e i tipi di porta in ports/ (dataset, model, stream, generic-io, rest, multiple, monitoring).
Il tool validate-metamodel, eseguito anche da commit-and-push-service prima del commit, applica queste regole:
meta-model.jsondeve contenerename,version,description,accessLevel,mode,url,propertiesemarkDowncon il relativovalue.nameusa lettere minuscole, cifre e trattini, non può iniziare o terminare con un trattino ed è lungo al massimo 30 caratteri.- Il
valueTypedelle proprietà è uno traSTRING,BOOLEAN,DOUBLE,JSON(non esisteINT). - Al massimo una proprietà ha
inputData: truee al massimo una haoutputData: true. - Ogni proprietà, tranne
assets, deve avere un argomento corrispondente insrc/arguments.py. - Gli argomenti
BOOLEANusanotype=str2bool(nontype=boolnéstore_true/store_false) earguments.pydeve definirestr2bool; gli argomentiDOUBLEusanotype=floatotype=int.
Configurazione runtime
- Il modello si imposta con la variabile d'ambiente
OPENCODE_MODEL(predefinitoopencode/musa-spark-1.3-free). È configurato anche un provider Ollama locale suhttp://localhost:11434/v1; i provideropenai,geminiegitlabsono disabilitati. - All'avvio la configurazione viene estesa tramite
OPENCODE_CONFIG_CONTENTcon il solo plugin@mlflow/opencode(se MLflow è abilitato) e con i server MCP remoti individuati dalle porte di ingresso. - Permessi: l'agente può eseguire comandi di shell e leggere qualsiasi directory, non può porre domande interattive e non può modificare
/opencode/docsné/opencode/skills.AGENTS.mdviene sempre caricato come istruzioni. - OpenCode viene servito con
opencode servesulla porta10000(modificabile conOPENCODE_PORT), che espone le API e lo stream SSE. Per i client browser che richiedono CORS, la repository include unsse_proxy.jsfacoltativo in ascolto sulla porta3001, che inoltra/sse-proxy?target=<url>come event stream e/http-proxy?target=<url>come normale HTTP.