Deploy e utilizzo dei modelli
ALIDA permette di deployare i modelli prodotti dai Service e di interrogarli tramite un endpoint REST esposto dalla piattaforma, senza necessità di configurazione infrastrutturale da parte dell'utente.
Pagina di dettaglio del modello
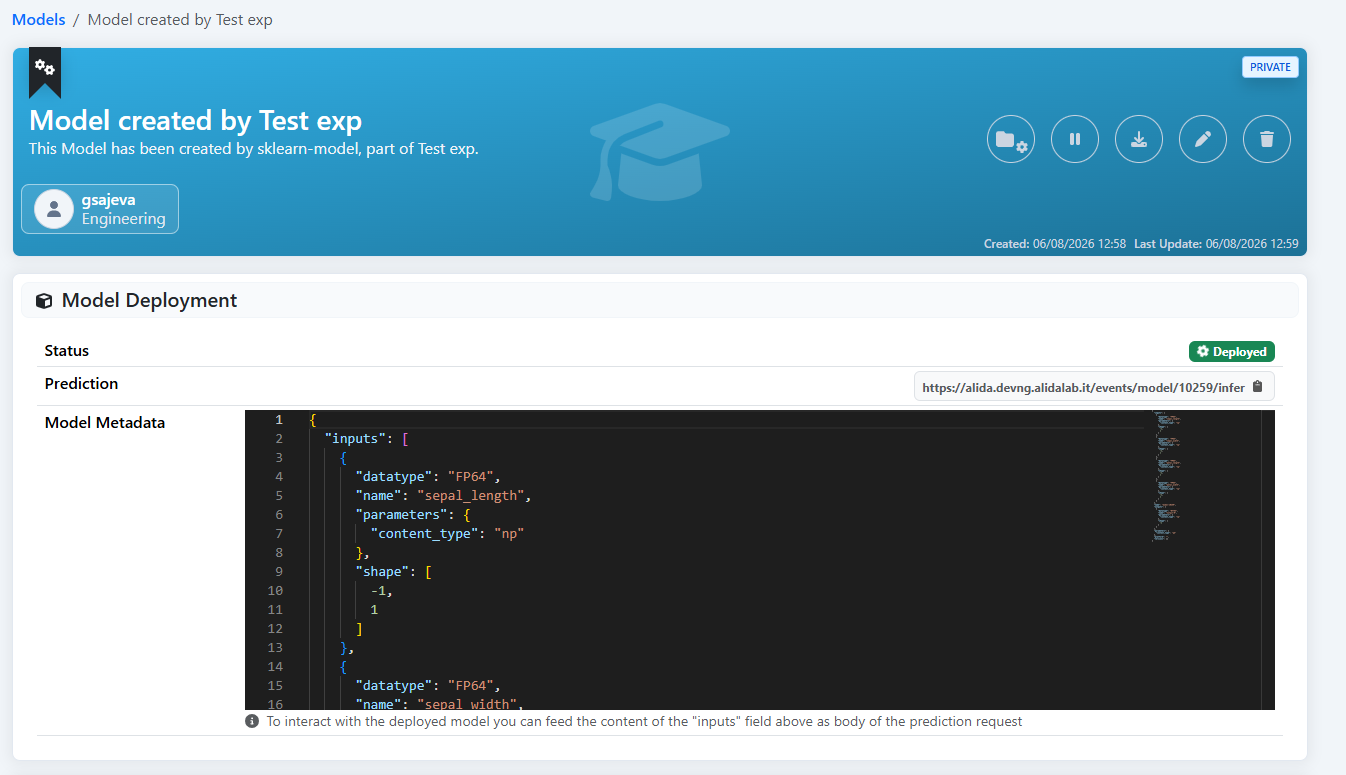
Per accedere alla pagina di dettaglio di un modello, raggiungere la sezione Data Management → Model dal menù laterale e cliccare sulla card del modello desiderato.
La pagina di dettaglio mostra, tra le altre informazioni, la sezione Model Deployment, che riporta:
- Status — stato attuale del deploy (
Deployed/ non deployato) - Prediction — URL dell'endpoint di inferenza (visibile solo quando il modello è deployato)
- Model Metadata — schema JSON degli input e output esposti dal modello, da usare per costruire le richieste di inferenza
Deploy di un modello
Dalla pagina di dettaglio del modello, cliccare sul pulsante  nella barra in alto a destra.
ALIDA scarica automaticamente gli artefatti del modello dallo storage e li rende disponibili al runtime di inferenza. Una volta completato il processo, lo Status nella sezione Model Deployment diventa Deployed e l'URL dell'endpoint è visibile nel campo Prediction.
!!! note "Nota" Il pulsante di deploy è disponibile solo per i modelli prodotti da Service configurati per supportare il serving. Se il pulsante non è presente, contattare il developer responsabile del Service.
Per interrompere il serving di un modello è possibile cliccare sul pulsante di pausa  nella stessa barra.
Endpoint di metadata
Una volta deployato, è possibile interrogare l'endpoint di metadata del modello per ottenere lo schema di input/output in formato JSON. L'URL è lo stesso del campo Prediction ma senza /infer:
GET https://<namespace>.alidalab.it/events/model/<id>La risposta contiene gli stessi campi visibili nella sezione Model Metadata della pagina di dettaglio.
Interrogare il modello
L'endpoint di inferenza esposto da ALIDA accetta richieste in formato V2 Inference Protocol. L'URL è visibile nel campo Prediction della pagina di dettaglio del modello:
POST https://<namespace>.alidalab.it/events/model/<id>/inferLeggere i Model Metadata
Prima di costruire una richiesta di inferenza, leggere attentamente il campo Model Metadata nella pagina di dettaglio del modello (o interrogare l'endpoint di metadata descritto sopra). Contiene lo schema completo degli input e degli output del modello in formato JSON.
Inputs — ogni elemento dell'array inputs descrive una feature accettata dal modello:
name— nome della feature, da usare identico nella richiestadatatype— tipo di dato V2 (es.FP64,FP32,INT64,BYTES)shape— dimensioni del tensore; il primo valore è-1come placeholder per il numero di campioni (batch size). Nella richiesta effettiva, sostituire-1con il numero reale di campioni che si vuole inviareparameters.content_type— (se presente) indica come MLServer decodifica i dati dell'input prima di passarli al modello:np: i dati vengono interpretati comenumpy.ndarray;shapeviene usato per ricostruire la forma del tensore dal campodata(che è sempre piatto nel protocollo V2)pd: gli input vengono aggregati in unpandas.DataFrame, dove il nome di ciascun input diventa il nome di una colonna; tipico per modelli tabellari con tipi misti o trasformazioni basate sui nomi delle colonnestr: i dati vengono interpretati come stringhe UTF-8base64: i dati vengono interpretati come byte codificati in base64datetime: i dati vengono interpretati come date in formato ISO 8601
Il content_type può essere specificato a livello di request (si applica a tutti gli input) o a livello di singolo input. I content type specificati esplicitamente nella richiesta hanno sempre precedenza su quelli definiti nei metadata del modello. Se il metadata definisce un content_type e la richiesta non lo specifica, viene usato quello dei metadata come default.
Outputs — ogni elemento dell'array outputs descrive un output disponibile del modello. Il campo outputs rappresenta il contratto esposto dal modello: solo gli output dichiarati lì sono richiedibili. Se il modello espone più output, è possibile scegliere quale richiedere nella richiesta di inferenza. Se non si specifica nulla nella richiesta, viene restituito l'output di default.
Esempio di Model Metadata:
{
  "inputs": [
    {
      "name": "sepal_length",
      "datatype": "FP64",
      "shape": [-1]
    },
    {
      "name": "sepal_width",
      "datatype": "FP64",
      "shape": [-1]
    }
  ],
  "outputs": [
    { "name": "predict",       "datatype": "INT64", "shape": [-1, 1] },
    { "name": "predict_proba", "datatype": "FP64",  "shape": [-1, 3] }
  ]
}Questo modello accetta due feature numeriche ed espone due output: la classe predetta (predict) e le probabilità per ciascuna delle 3 classi (predict_proba). Per inviare un singolo campione, sostituire -1 con 1 in tutti gli shape degli input.
Ottenere una API Key
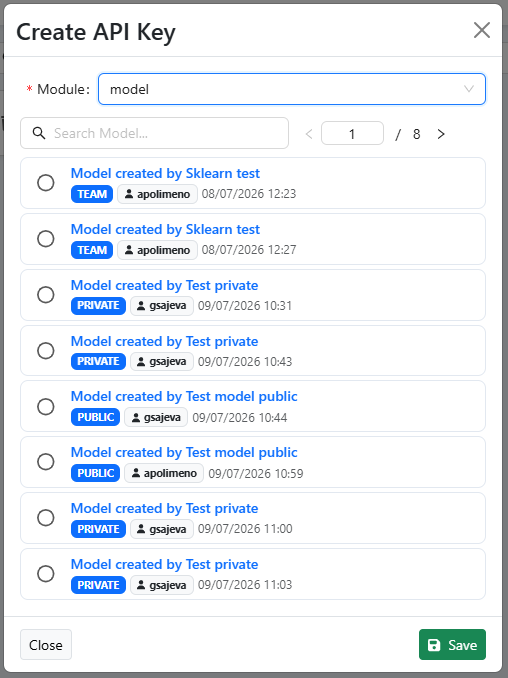
Per interrogare un modello deployato dall'esterno della piattaforma è necessaria una API Key. Per crearla:
- Accedere alla sezione API Key dal menù laterale
- Cliccare su + Crea API Key
- Selezionare:
- Module:
model - Role: il modello specifico che si vuole interrogare
- Module:
- Cliccare su Salva e conservare la chiave generata
!!! warning "Attenzione" La chiave viene mostrata una sola volta al momento della creazione. Conservarla con cura: non sarà più possibile visualizzarla in seguito.
Costruire la richiesta
La richiesta contiene tre campi principali:
inputs— array di input, ciascuno conname,shape,datatype,datae opzionalmenteparameters.content_type. Copiare i campiname,datatypeeparametersdal metadata; sostituire il-1nelloshapecon il numero di campioni; fornire i valori nel campodata.outputs— (opzionale) array di output richiesti. Se omesso, viene restituito l'output di default. Se presente, specificare{ "name": "<nome-output>" }per ciascun output desiderato tra quelli dichiarati nei metadata.parameters— (opzionale) parametri a livello di request, ad esempio"content_type": "pd"per aggregare tutti gli input in un DataFrame.
Esempi di richiesta
Singolo campione, output di default:
curl -X POST \
  "https://<namespace>.alidalab.it/events/model/<id>/infer" \
  --header "Authorization: Apikey <api-key>" \
  --header "Content-Type: application/json" \
  --data '{
    "inputs": [
      {
        "name": "sepal_length",
        "datatype": "FP64",
        "shape": [1],
        "data": [5.1]
      },
      {
        "name": "sepal_width",
        "datatype": "FP64",
        "shape": [1],
        "data": [3.5]
      }
    ]
}'Singolo campione, output specifico (predict_proba):
curl -X POST \
  "https://<namespace>.alidalab.it/events/model/<id>/infer" \
  --header "Authorization: Apikey <api-key>" \
  --header "Content-Type: application/json" \
  --data '{
    "inputs": [
      {
        "name": "sepal_length",
        "datatype": "FP64",
        "shape": [1],
        "data": [5.1]
      },
      {
        "name": "sepal_width",
        "datatype": "FP64",
        "shape": [1],
        "data": [3.5]
      }
    ],
    "outputs": [
      { "name": "predict_proba" }
    ]
}'Batch (3 campioni), output di default:
curl -X POST \
  "https://<namespace>.alidalab.it/events/model/<id>/infer" \
  --header "Authorization: Apikey <api-key>" \
  --header "Content-Type: application/json" \
  --data '{
    "inputs": [
      {
        "name": "sepal_length",
        "datatype": "FP64",
        "shape": [3],
        "data": [5.1, 6.3, 4.7]
      },
      {
        "name": "sepal_width",
        "datatype": "FP64",
        "shape": [3],
        "data": [3.5, 2.8, 3.2]
      }
    ]
}'Esempi di risposta
Output di default (predict), singolo campione:
{
  "model_name": "model-<id>",
  "outputs": [
    {
      "name": "predict",
      "shape": [1, 1],
      "datatype": "INT64",
      "data": [0]
    }
  ]
}predict_proba richiesto esplicitamente, singolo campione (3 classi):
{
  "model_name": "model-<id>",
  "outputs": [
    {
      "name": "predict_proba",
      "shape": [1, 3],
      "datatype": "FP64",
      "data": [0.85, 0.10, 0.05]
    }
  ]
}Batch (3 campioni), output di default:
{
  "model_name": "model-<id>",
  "outputs": [
    {
      "name": "predict",
      "shape": [3, 1],
      "datatype": "INT64",
      "data": [0, 2, 1]
    }
  ]
}Il campo data nell'output contiene le predizioni, una per ciascun campione inviato. I nomi degli output disponibili e il loro significato sono descritti nella documentazione del Service che ha prodotto il modello.